Para que ChatGPT, Gemini, Perplexity o los resúmenes con IA de Google citen a un medio, el sitio tiene que poder leerse sin trabas, cada nota tiene que decir con claridad quién la escribió, cuándo y para qué medio, y el contenido tiene que aportar algo que no esté en otros cien sitios. La parte técnica la puede resolver el sistema; la parte de contenido original depende de la redacción. Nadie puede garantizar que una IA te cite, pero sí podés sacar los obstáculos.
Cómo eligen las IA qué medios citar
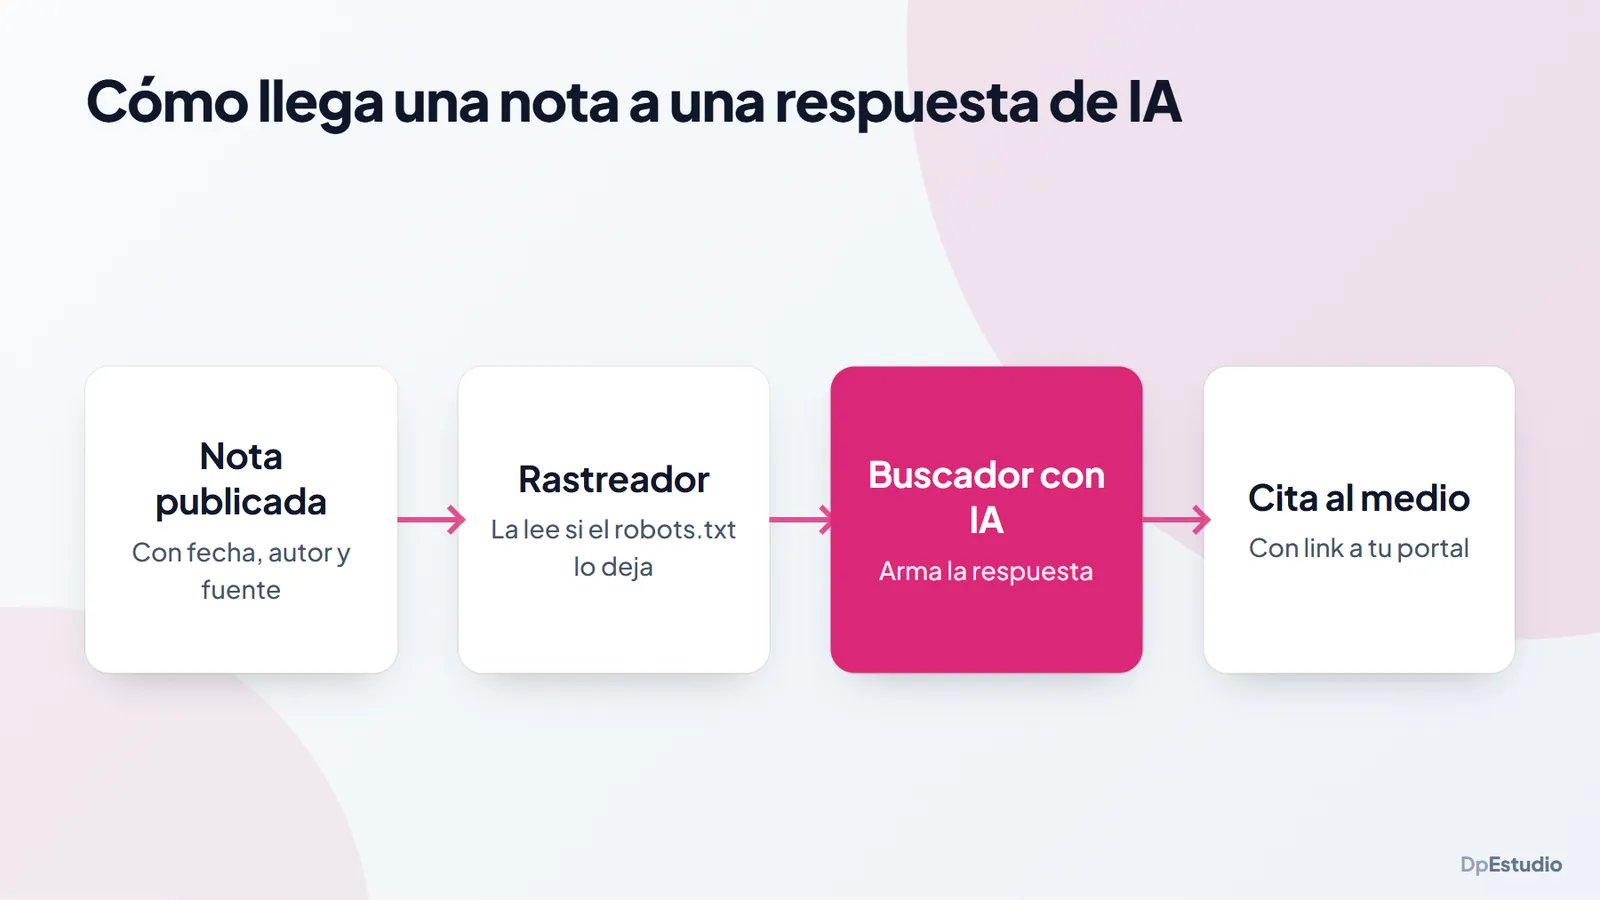
Los asistentes con búsqueda, como ChatGPT con búsqueda, Perplexity, Gemini o los AI Overviews de Google, funcionan parecido: reciben una pregunta, buscan en la web, leen algunas páginas y arman una respuesta con links a las fuentes que usaron. Para que tu nota sea una de esas fuentes tienen que pasar tres cosas: que el rastreador pueda entrar, que entienda la página y que la considere confiable para esa pregunta.
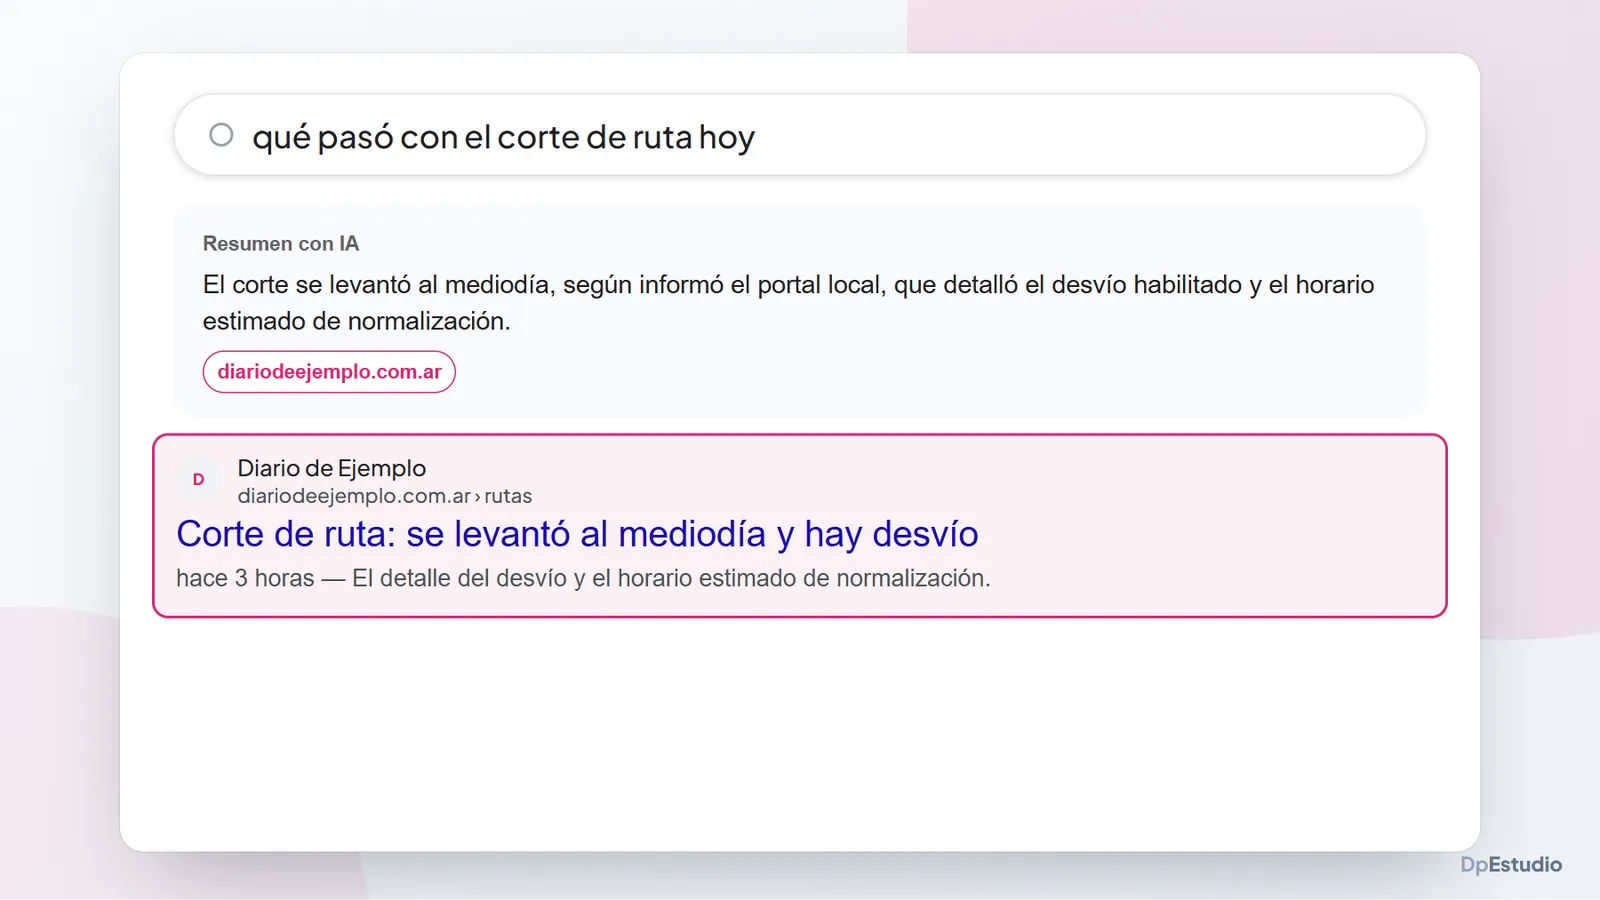
Cómo pondera cada empresa esas señales no es público, y cambia seguido. Lo que sí está claro es lo que les complica el trabajo: sitios que bloquean rastreadores, contenido que solo aparece después de ejecutar JavaScript, notas sin autor ni fecha, medios sin información sobre quién los hace y textos copiados de otro lado.
Gran parte de esto coincide con lo que Google pide desde hace años para noticias. Si querés el panorama general de SEO y buscadores con IA, está en SEO en la era de Google con IA.
Los rastreadores de IA: quién es quién
Cada empresa usa sus propios rastreadores, y no todos hacen lo mismo. La diferencia importa porque en el robots.txt se pueden permitir o bloquear por separado.
| Nombre | Empresa | Para qué se usa, según la empresa |
|---|---|---|
| GPTBot | OpenAI | Recolectar contenido que puede usarse para entrenar modelos. |
| OAI-SearchBot | OpenAI | Mostrar sitios en las respuestas de búsqueda de ChatGPT. |
| Google-Extended | No es un rastreador aparte: es una indicación en el robots.txt que controla si el contenido se usa para Gemini. No afecta la búsqueda de Google. | |
| PerplexityBot | Perplexity | Encontrar y enlazar sitios en los resultados de Perplexity. |
| ClaudeBot | Anthropic | Recolectar contenido que puede usarse para entrenar modelos. Anthropic usa otros nombres para búsqueda y para pedidos de usuarios. |
Dos consecuencias prácticas. Primero, bloquear GPTBot no es lo mismo que bloquear OAI-SearchBot: un medio puede decidir que no quiere que su contenido entrene modelos y aun así querer aparecer como fuente en ChatGPT. Segundo, los AI Overviews de Google forman parte de la búsqueda y dependen del rastreo normal de Googlebot; bloquear Google-Extended no te saca de ahí.
Estas políticas cambian. Antes de tocar el robots.txt conviene revisar la documentación vigente de cada empresa.
Qué hace DP Portal con el robots.txt
El robots.txt de cada portal de DP Portal permite el acceso a todos los rastreadores. Solo deja afuera dos cosas que no tienen sentido indexar: el panel de administración y los resultados del buscador interno. Además, el mismo archivo indica dónde están el sitemap general y el de noticias.
Eso significa que, de entrada, ningún rastreador de IA queda bloqueado. Si tu medio tiene una postura editorial sobre el uso de su contenido para entrenar modelos, es una conversación que vale la pena tener antes de tocar nada, sabiendo la diferencia entre rastreadores de entrenamiento y de búsqueda que explicamos arriba.
Y el llms.txt, ¿sirve?
El llms.txt es una propuesta de archivo de texto, ubicado en la raíz del sitio, que resume el contenido para que lo lean modelos de lenguaje. Se empezó a hablar mucho de él, pero conviene ponerlo en su lugar: no es un estándar adoptado y ninguno de los grandes buscadores ni asistentes se comprometió a usarlo para decidir a quién citar.
Para un portal de noticias, lo que los rastreadores efectivamente leen es otra cosa: el HTML de cada nota, el sitemap, el RSS y los datos estructurados. Si eso está bien resuelto, el llms.txt no cambia el panorama. Si eso está mal, un llms.txt no lo arregla.
Lo que resuelve el sistema en cada nota
La parte técnica de un portal de DP Portal está pensada para que cualquier buscador, con o sin IA, pueda leer y entender cada nota:
- Páginas generadas en el servidor. El texto de la nota está en el HTML desde el primer momento, sin depender de JavaScript. Varios rastreadores no ejecutan JavaScript, así que esto es básico.
- Datos estructurados NewsArticle con titular, fotos, fecha de publicación, fecha de modificación, autor y medio.
- Páginas de autor marcadas como perfil, para que la firma de cada nota tenga una página detrás.
- Canonical, breadcrumbs y direcciones limpias con el título de la nota.
- Sitemap general, sitemap de noticias y RSS general y por sección con el texto completo.
- Aviso al publicar por IndexNow, que usan Bing y otros buscadores, y por WebSub para los feeds.
- Sitio rápido: fotos en WebP, foto principal precargada y con medidas, sin plugins pesados.
El detalle de cada punto está en la nota sobre SEO automático para portales de noticias, y la velocidad tiene su propia guía en Core Web Vitals e INP.
Páginas institucionales: quién hace el medio
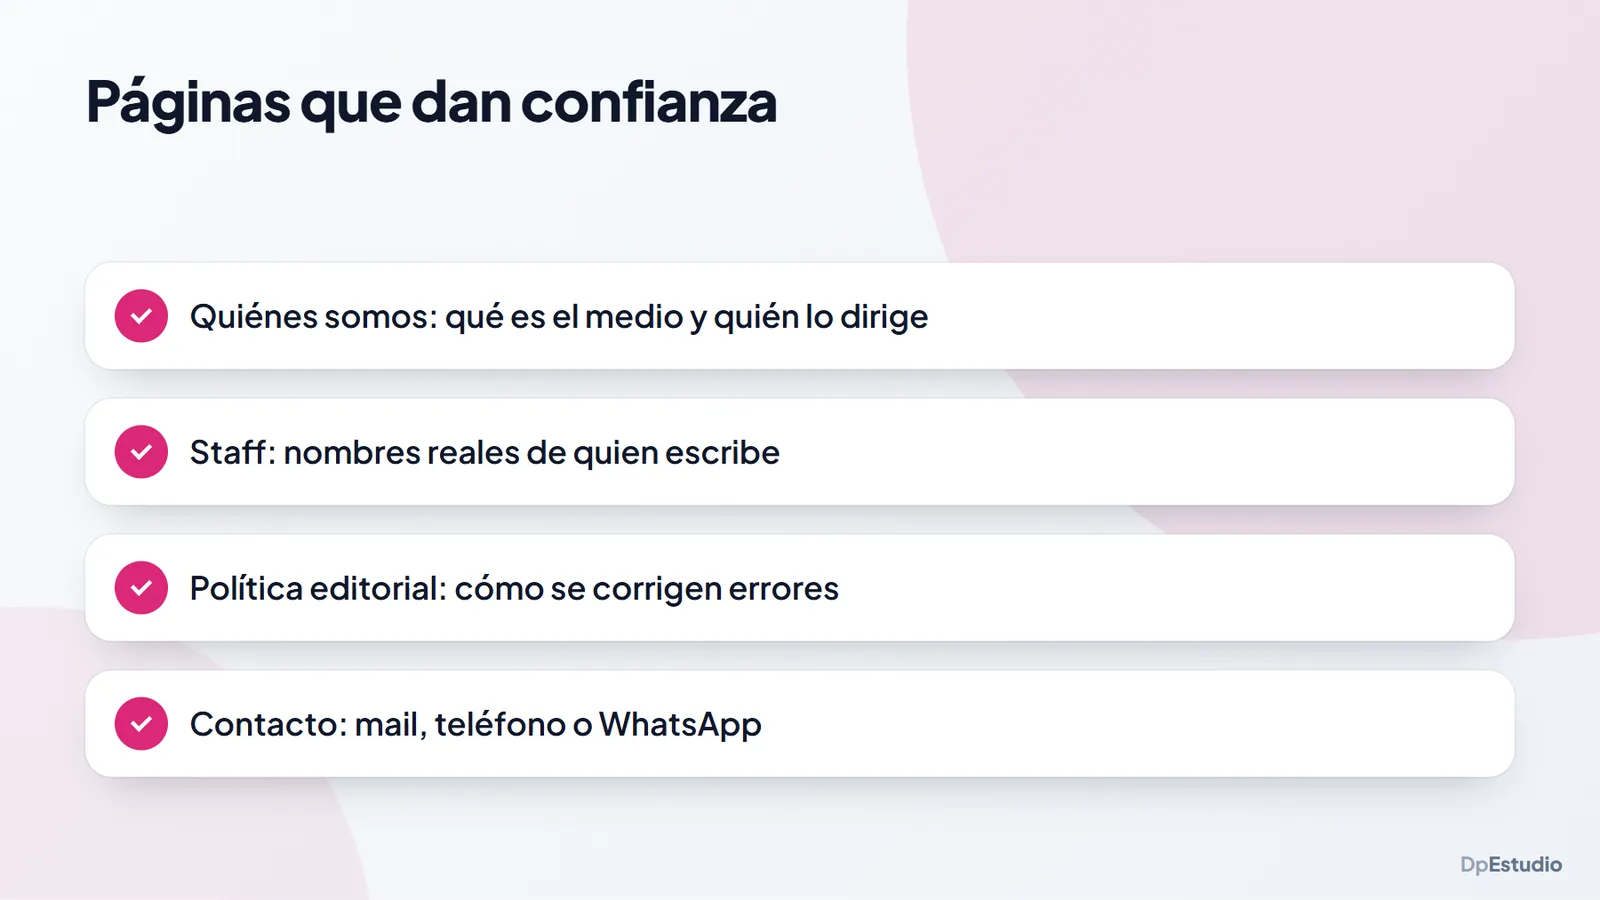
Un asistente que tiene que elegir entre dos fuentes va a preferir la que deja claro quién está detrás. Lo mismo pide Google para noticias. Las páginas que conviene tener completas:
- Quiénes somos: qué es el medio, desde cuándo, de dónde, quién lo dirige.
- Staff: nombres reales de quienes escriben y editan.
- Política editorial: cómo se trabaja, cómo se corrigen errores.
- Contacto: mail, teléfono o WhatsApp visibles.
En DP Portal son páginas fijas que cargás desde el panel. El chequeo de la pantalla Google y conexiones, además, te marca si falta la página Quiénes somos o los datos de contacto. Cómo funciona esa pantalla está en cómo conectar el portal a Search Console, Analytics y AdSense.
Lo que depende de la redacción
Ningún sistema convierte en citable una nota que repite lo mismo que todos. Lo que más pesa está del lado editorial:
- Contenido original. El dato que conseguiste vos, la declaración que te dieron a vos, la foto que sacó tu fotógrafo. Si tu nota es el cable reescrito, la IA va a citar al que lo publicó primero.
- Respuesta en el primer párrafo. Qué pasó, dónde, cuándo. Los asistentes levantan fragmentos que se entienden solos.
- Firma real y fecha. Cada nota con autor, y si la actualizás, que se note.
- Cobertura constante de un tema o lugar. Un medio que cubre todos los días una ciudad o un tema tiene más chances de ser la fuente de referencia para preguntas sobre eso.
- Fuentes citadas. Decir de dónde sale cada dato le da a la nota más solidez para cualquiera que la lea, persona o sistema.
Un punto a decidir: si tenés notas exclusivas para lectores registrados, sin sesión solo se ve el primer párrafo, y los rastreadores tampoco acceden al resto. El sistema marca esas notas para Google como contenido que no es de acceso libre. Es una decisión válida, pero esas notas van a estar menos visibles afuera.
Si querés ver qué incluye DP Portal completo, está la página del sistema para portales de noticias de DpEstudio.
Preguntas frecuentes
¿Se puede pagar o pedir para aparecer en las respuestas de ChatGPT?
No hay una inscripción ni un pago para que ChatGPT cite a un medio. Lo que podés hacer es que el sitio sea fácil de leer para sus rastreadores y publicar contenido propio que valga la pena citar.
¿Qué diferencia hay entre GPTBot y OAI-SearchBot?
Según OpenAI, GPTBot recolecta contenido que puede usarse para entrenar modelos, y OAI-SearchBot es el que permite que un sitio aparezca en las respuestas de búsqueda de ChatGPT. Se controlan por separado en el robots.txt.
¿Si bloqueo Google-Extended salgo de los AI Overviews?
No. Google-Extended controla el uso del contenido para Gemini y no afecta la búsqueda de Google. Los AI Overviews son parte de la búsqueda y dependen del rastreo normal de Googlebot.
¿Necesito un archivo llms.txt?
Es una propuesta, no un estándar, y ningún buscador grande se comprometió a usarlo para decidir a quién citar. Pesa mucho más tener notas legibles, sitemap y datos estructurados.
¿DP Portal bloquea a los rastreadores de IA?
No. El robots.txt de los portales permite el acceso a todos los rastreadores y solo deja afuera el panel de administración y el buscador interno.
¿Las notas exclusivas para registrados pueden aparecer en respuestas de IA?
Sin sesión solo se ve el primer párrafo, así que un rastreador tampoco accede al resto. Es una decisión editorial: lo exclusivo suma valor para el lector registrado pero queda menos visible afuera.